判断很少从完全空白开始。看到一份检测结果、听到一条消息,或者观察到一次实验,我们通常已经有一些背景认识。贝叶斯方法给出了一种明确的更新规则:把原来的判断和新证据放在一起,算出更新后的判断。
这里的“原来”与“后来”对应先验与后验。它们可以变化;变化的依据和计算过程应该能够说清楚。
从条件概率开始#
设 H 表示一个假设,D 表示观察到的数据。当 P(D)>0 时,条件概率定义为:
P(H∣D)=P(D)P(H∩D).
把同一个交集反过来写,又有:
P(D∣H)=P(H)P(H∩D).
在 P(H)>0 时,两式相连,就得到贝叶斯公式:
P(H∣D)=P(D)P(D∣H)P(H).
四个量各有含义:
| 符号 |
名称 |
要回答的问题 |
| P(H) |
先验概率 |
看数据之前,对假设有多大把握? |
| P(D∣H) |
似然 |
假设成立时,这份数据出现的可能性有多大? |
| P(D) |
证据的边缘概率 |
在所有考虑的情况中,数据出现的总概率是多少? |
| P(H∣D) |
后验概率 |
看过数据之后,对假设有多大把握? |
最容易混淆的是 P(D∣H) 与 P(H∣D)。前者高,并不能单独推出后者高;背景中的先验比例也在起作用。[1]
如果 H1,…,Hm 互斥且穷尽所有情况,那么分母可以通过全概率公式计算:
P(D)=j=1∑mP(D∣Hj)P(Hj).
因此,多假设版本可以写成:
P(Hi∣D)=∑j=1mP(D∣Hj)P(Hj)P(D∣Hi)P(Hi).
一次阳性,为什么可能只对应六分之一?#
看一个教学用的假设例子。某种情况在人群中的比例为 1%,检测的灵敏度是 99%,特异度是 95%。记 H 为确实存在该情况,+ 为检测阳性,则:
P(H)=0.01,P(+∣H)=0.99,P(+∣¬H)=0.05.
代入以后:
P(H∣+)=0.99×0.01+0.05×0.990.99×0.01=0.05940.0099=61≈16.7%.
换成一万人会更直观:其中约一百人存在该情况,预期出现九十九个真阳性;另外九千九百人中,预期出现四百九十五个假阳性。所有阳性中,真阳性的比例就是:
99+49599=61.
这里的数量是按假设概率计算的期望数量,并非一组真实临床数据。这个例子也不能直接套到某项现实检测上;真实应用需要核对适用人群、检测性能与具体条件。
用赔率看,一次更新像一次乘法#
把概率换成赔率,贝叶斯更新会更紧凑。定义:
O(H)=1−P(H)P(H).
当相关分母非零时:
后验赔率P(¬H∣D)P(H∣D)=似然比P(D∣¬H)P(D∣H)先验赔率P(¬H)P(H).
在刚才的例子中,先验赔率为 1:99,阳性的似然比为 0.99/0.05=19.8,后验赔率变成 1:5,换回概率仍是 1/6。
若多份证据在给定 H 和给定 ¬H 的条件下分别独立,似然比可以相乘;取对数以后就是相加:
logO(H∣D1,…,Dn)=logO(H)+i=1∑nlogP(Di∣¬H)P(Di∣H).
条件独立很关键。把同一条消息的十次转发当成十份独立证据,会人为放大信心。
从“假设真假”走向“参数是多少”#
现在把问题换成一枚硬币。它朝上的概率 θ 不一定等于 1/2。我们对 θ 的认识,可以用区间 (0,1) 上的概率密度来表示。
一个常见选择是 Beta 先验:
p(θ)=B(α,β)θα−1(1−θ)β−1,α,β>0,
其中归一化常数为:
B(α,β)=∫01uα−1(1−u)β−1du=Γ(α+β)Γ(α)Γ(β).
这里的 p(θ) 是密度,其数值可以大于一;某段区间下的面积才是对应概率。对连续参数来说,单个精确点的概率通常为零。
假定 n 次试验在给定 θ 时独立,每次成功概率都为 θ,观察到 k 次成功,则二项似然是:
p(k∣θ)=(kn)θk(1−θ)n−k.
对于固定数据,省去与 θ 无关的常数,后验满足:
p(θ∣k)∝p(k∣θ)p(θ)∝θα+k−1(1−θ)β+n−k−1.
于是:
θ∣k∼Beta(α+k, β+n−k).
先验与后验属于同一个分布家族,这就是这个模型中的共轭性。[2]
十次实验之后,我们知道了多少?#
假设先验为 Beta(2,2),十次试验中七次成功、三次失败,那么:
θ∣D∼Beta(9,5).
后验均值为:
E[θ∣D]=149≈0.643.
后验方差为:
Var(θ∣D)=142(14+1)9×5=294045≈0.0153.
由于两个参数都大于一,后验众数也存在于区间内部:
θMAP=9+5−29−1=32.
均值、众数和观测频率 7/10 回答的是不同的问题,不必相等。下一次试验成功的后验预测概率,则需要对不确定的 θ 积分:
P(Xnext=1∣D)=∫01θp(θ∣D)dθ=149.
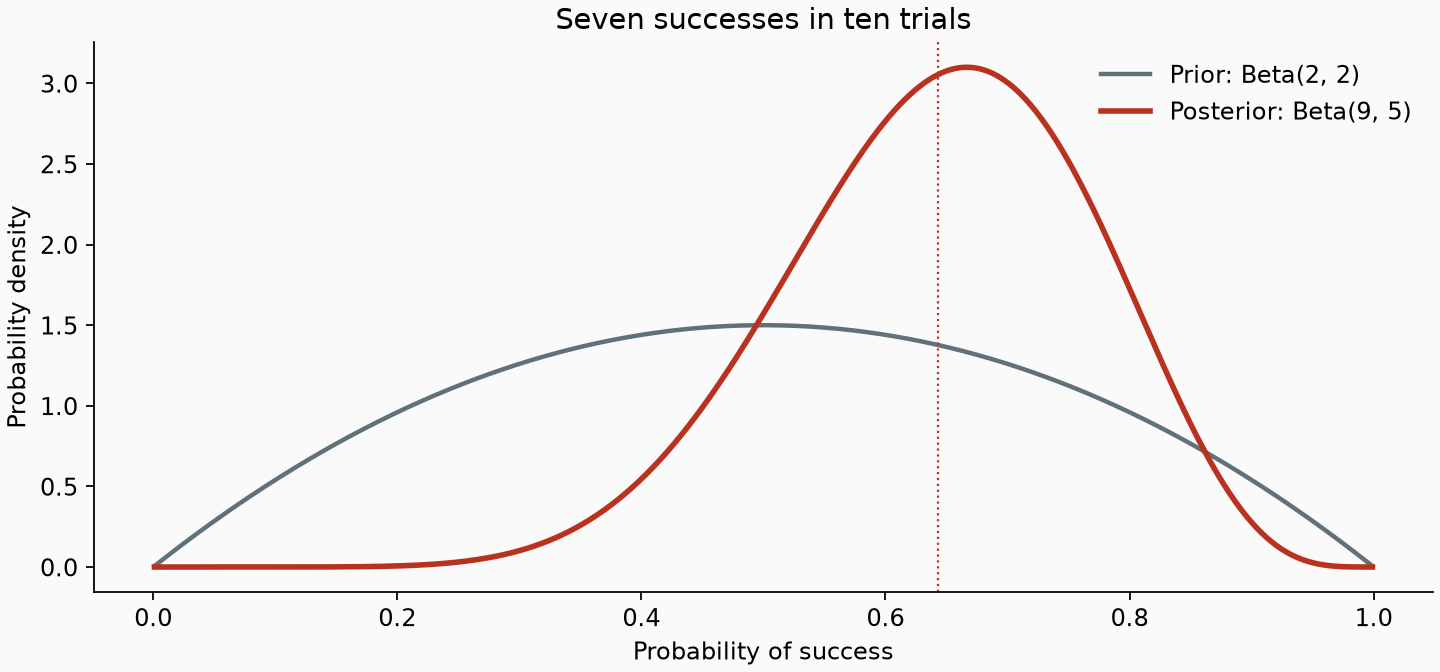
图中的后验比先验更偏向较高的成功概率,但仍然有明显宽度。十次实验带来了信息,也留下了不确定性。
对这个模型,观察完一批数据后的后验可以作为下一批数据的先验。只要试验条件与独立性假设不变,分批更新与一次处理全部数据会得到相同结果:
αnew=α+i∑ki,βnew=β+i∑(ni−ki).
公式之外,还要检查什么?#
贝叶斯方法不会自动替我们选好模型。似然是否适合观测过程、先验有没有合理依据、数据是否存在选择偏差,都可能影响结论。
实际使用时,可以先画出先验与后验,再尝试几组合理先验,看结论是否稳定。若结果对先验非常敏感,那本身就是有用信息:现有数据还没有强到足以压过背景假设。
我更喜欢把贝叶斯理解成一种可检查的更新习惯:先把原来的判断摊开,再说明证据在不同假设下意味着什么,最后同时报告新的判断与剩余的不确定性。
延伸阅读#
- Bayes' theorem
- Beta distribution
评论
还没有评论。 来写第一条。